
В документе описаны технологии достижения отказоустойчивости в кластерных инсталляциях VK WorkSpace. Документ будет полезен системным инженерам и архитекторам.
В документе используются следующие понятия:
Отказоустойчивость — способность системы переносить без потерь выход из строя одного или нескольких компонентов.
Минимальная отказоустройчивая конфигурация состоит из:
- двух ВМ (виртуальных машин) или физических серверов под фронты,
- двух ВМ или физических серверов под базы данных,
- трех ВМ или физических серверов под хранилища,
- одной ВМ или физических серверов под установщик + мониторинг.
Таким образом, в отказоустойчивом кластере должно быть минимум 8 ВМ.
Схема кластера для 8 ВМ выглядит следующим образом:
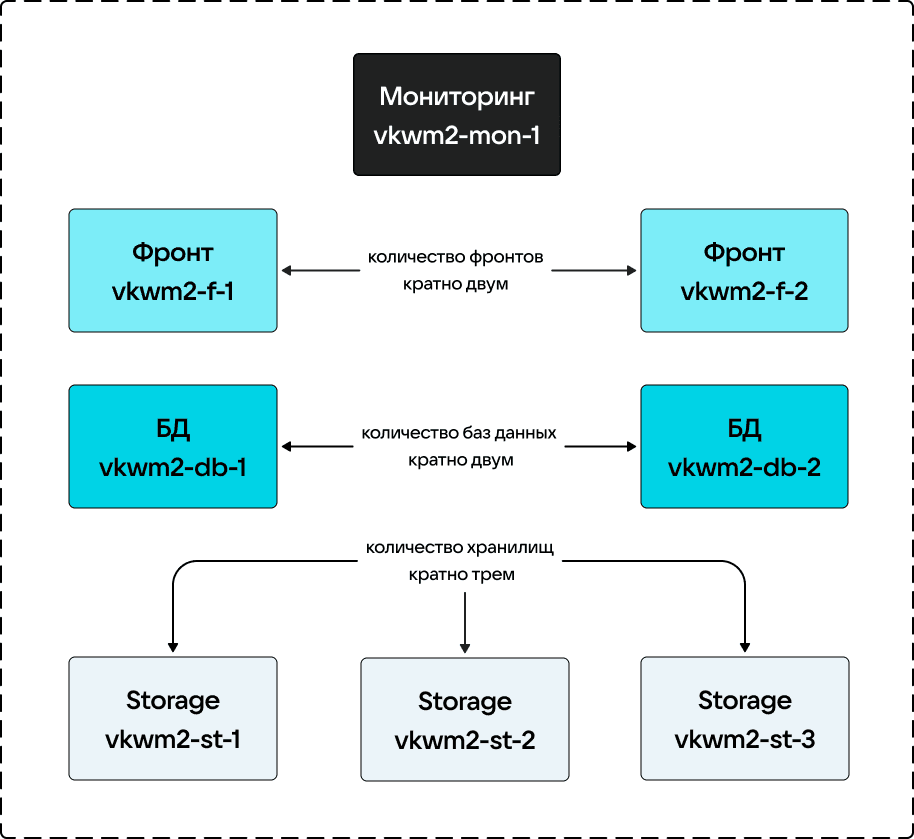
Единица отказоустойчивости — непосредственно сервер, на котором установлены компоненты VK WorkSpace, поэтому компоненты должны быть разнесены по трем выделенным площадкам. Например, ВМ могут находиться на разных полках/стойках/шкафах, но в одном ЦОД. Также может использоваться несколько ЦОД. Размещение на трех геораспределенных дата-центрах обеспечивает инсталляции катастрофоустройчивость.
Фронт — единица отказоустойчивости, которая обслуживает не только сервисы, ответственные за отображение информации, но и бизнес-логику, почтовый транспорт и API.
Для успешного построения отказоустойчивой инфраструктуры от персонала требуется:
- Знания Linux на уровне системного администратора
- Базовые знания по организации сетей
- Базовые знания почтовых протоколов
Перед установкой отказоустойчивой конфигурации Почты нужно обеспечить следующее:
- Три и более геораспределенных ЦОД.
- Минимум 8 ВМ или физических серверов с указанными выше ролями.
- Сетевую связанность всех компонентов системы обеспечена каналами не менее чем 10 Гб/с.
- Входящие каналы связи до фронтов — от 2Мб/с на пользователя.
- Рекомендуемая допустимая задержка в сети: 30 мс.
Для создания отказоустойчивой конфигурации на уровне фронтов необходимы минимум две единицы отказоустойчивости, размещенные на разных выделенных площадках.
В базовой конфигурации настраивается балансировка через DNS.
Реализована проверка работоспособности сервисов VK WorkSpace, которая производится раз в минуту с помощью Envoy. В случае если какой-либо компонент не отвечает, запрос перенаправляется на одноименный.
Отказоустойчивость на уровне БД достигается с помощью асинхронной master-slave репликации. Выбор лидера обеспечивается за счет алгоритма Raft.
Базы данных используются в двух экземплярах — им не нужен кворум из трех.
Основные используемые базы данных:
- PostgreSQL
- MySQL
- Tarantool
Реплицируемые базы данных, оркестрируются Patroni. В случае выхода из строя мастера Patroni выберет нового.
Голосование происходит через etcd: какая из реплик первой сделает запись в etcd, та станет мастером. Это работает и в случае наличия одной реплики — она автоматически становится мастером.
Split brain исключен, так как бывший мастер переводится в режим read-only.
Реплицируемые базы данных, управляются с помощью Consul + Orchestrator. Для MySQL orchestrator выбирает нового мастера (голосование проводится через Consul).
Реплицируемые базы данных. Управляются с помощью внутреннего сервиса Overlord (голосование проводится через etcd).
На уровне хранилищ отказоустойчивость достигается за счет разделения каждого из них на дисковые пары.
Минимальная отказоустойчивая конфигурация: 3 машины, на каждой из которых по 2 дисковых раздела — всего 6 разделов.
При такой конфигурации:
- Всегда есть пара на запись.
- Остальные пары доступны для чтения.
Таким образом:
- Хранилище №1 разделено на 2 части
- Хранилище №2 разделено на 2 части
- Хранилище №3 разделено на 2 части
Всего 6 разделов хранилищ (3 дисковые пары): 2 на одном сервере, 2 — на втором, еще 2 — на третьем.
При сборке хранилищ дисковые пары собираются из дисков, размещенных на разных выделенных площадках. Объединение происходит по принципу: 1-2, 2-3, 3-1.
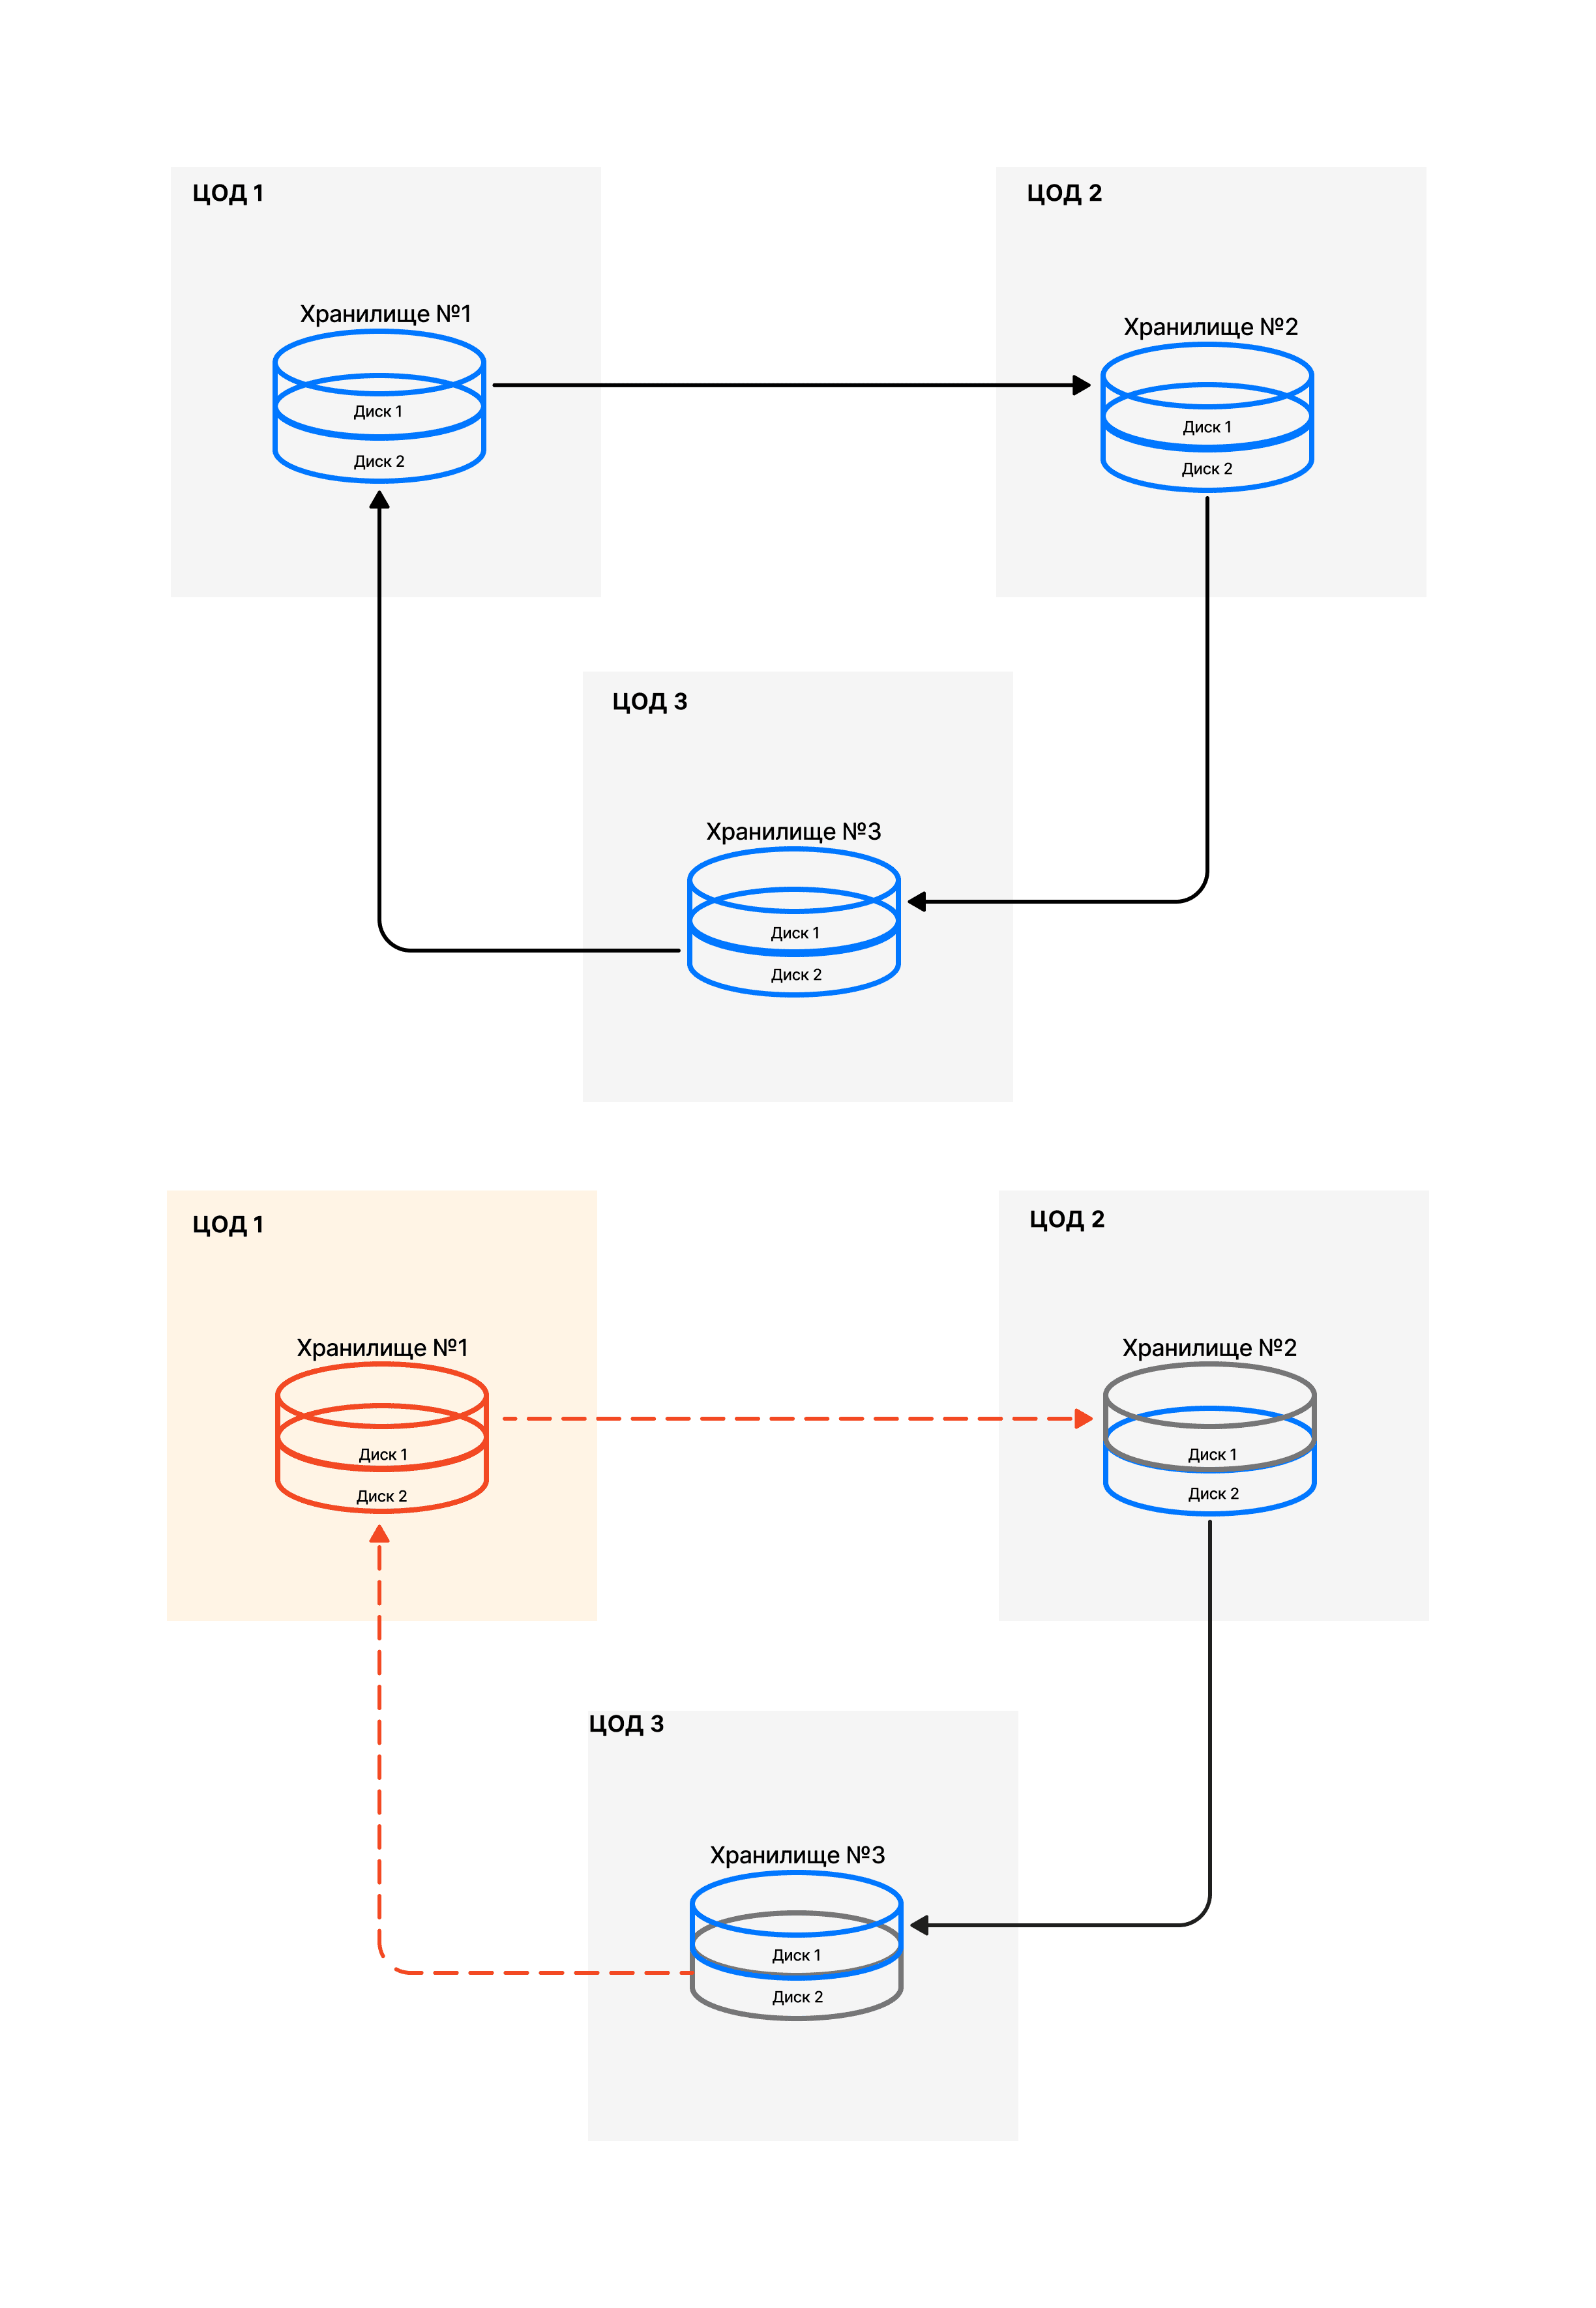
При выходе из строя одного из хранилищ данные не будут утеряны, так как остается еще по экземпляру данных, которые были в read-only.
Технический писатель: Груздев Никита